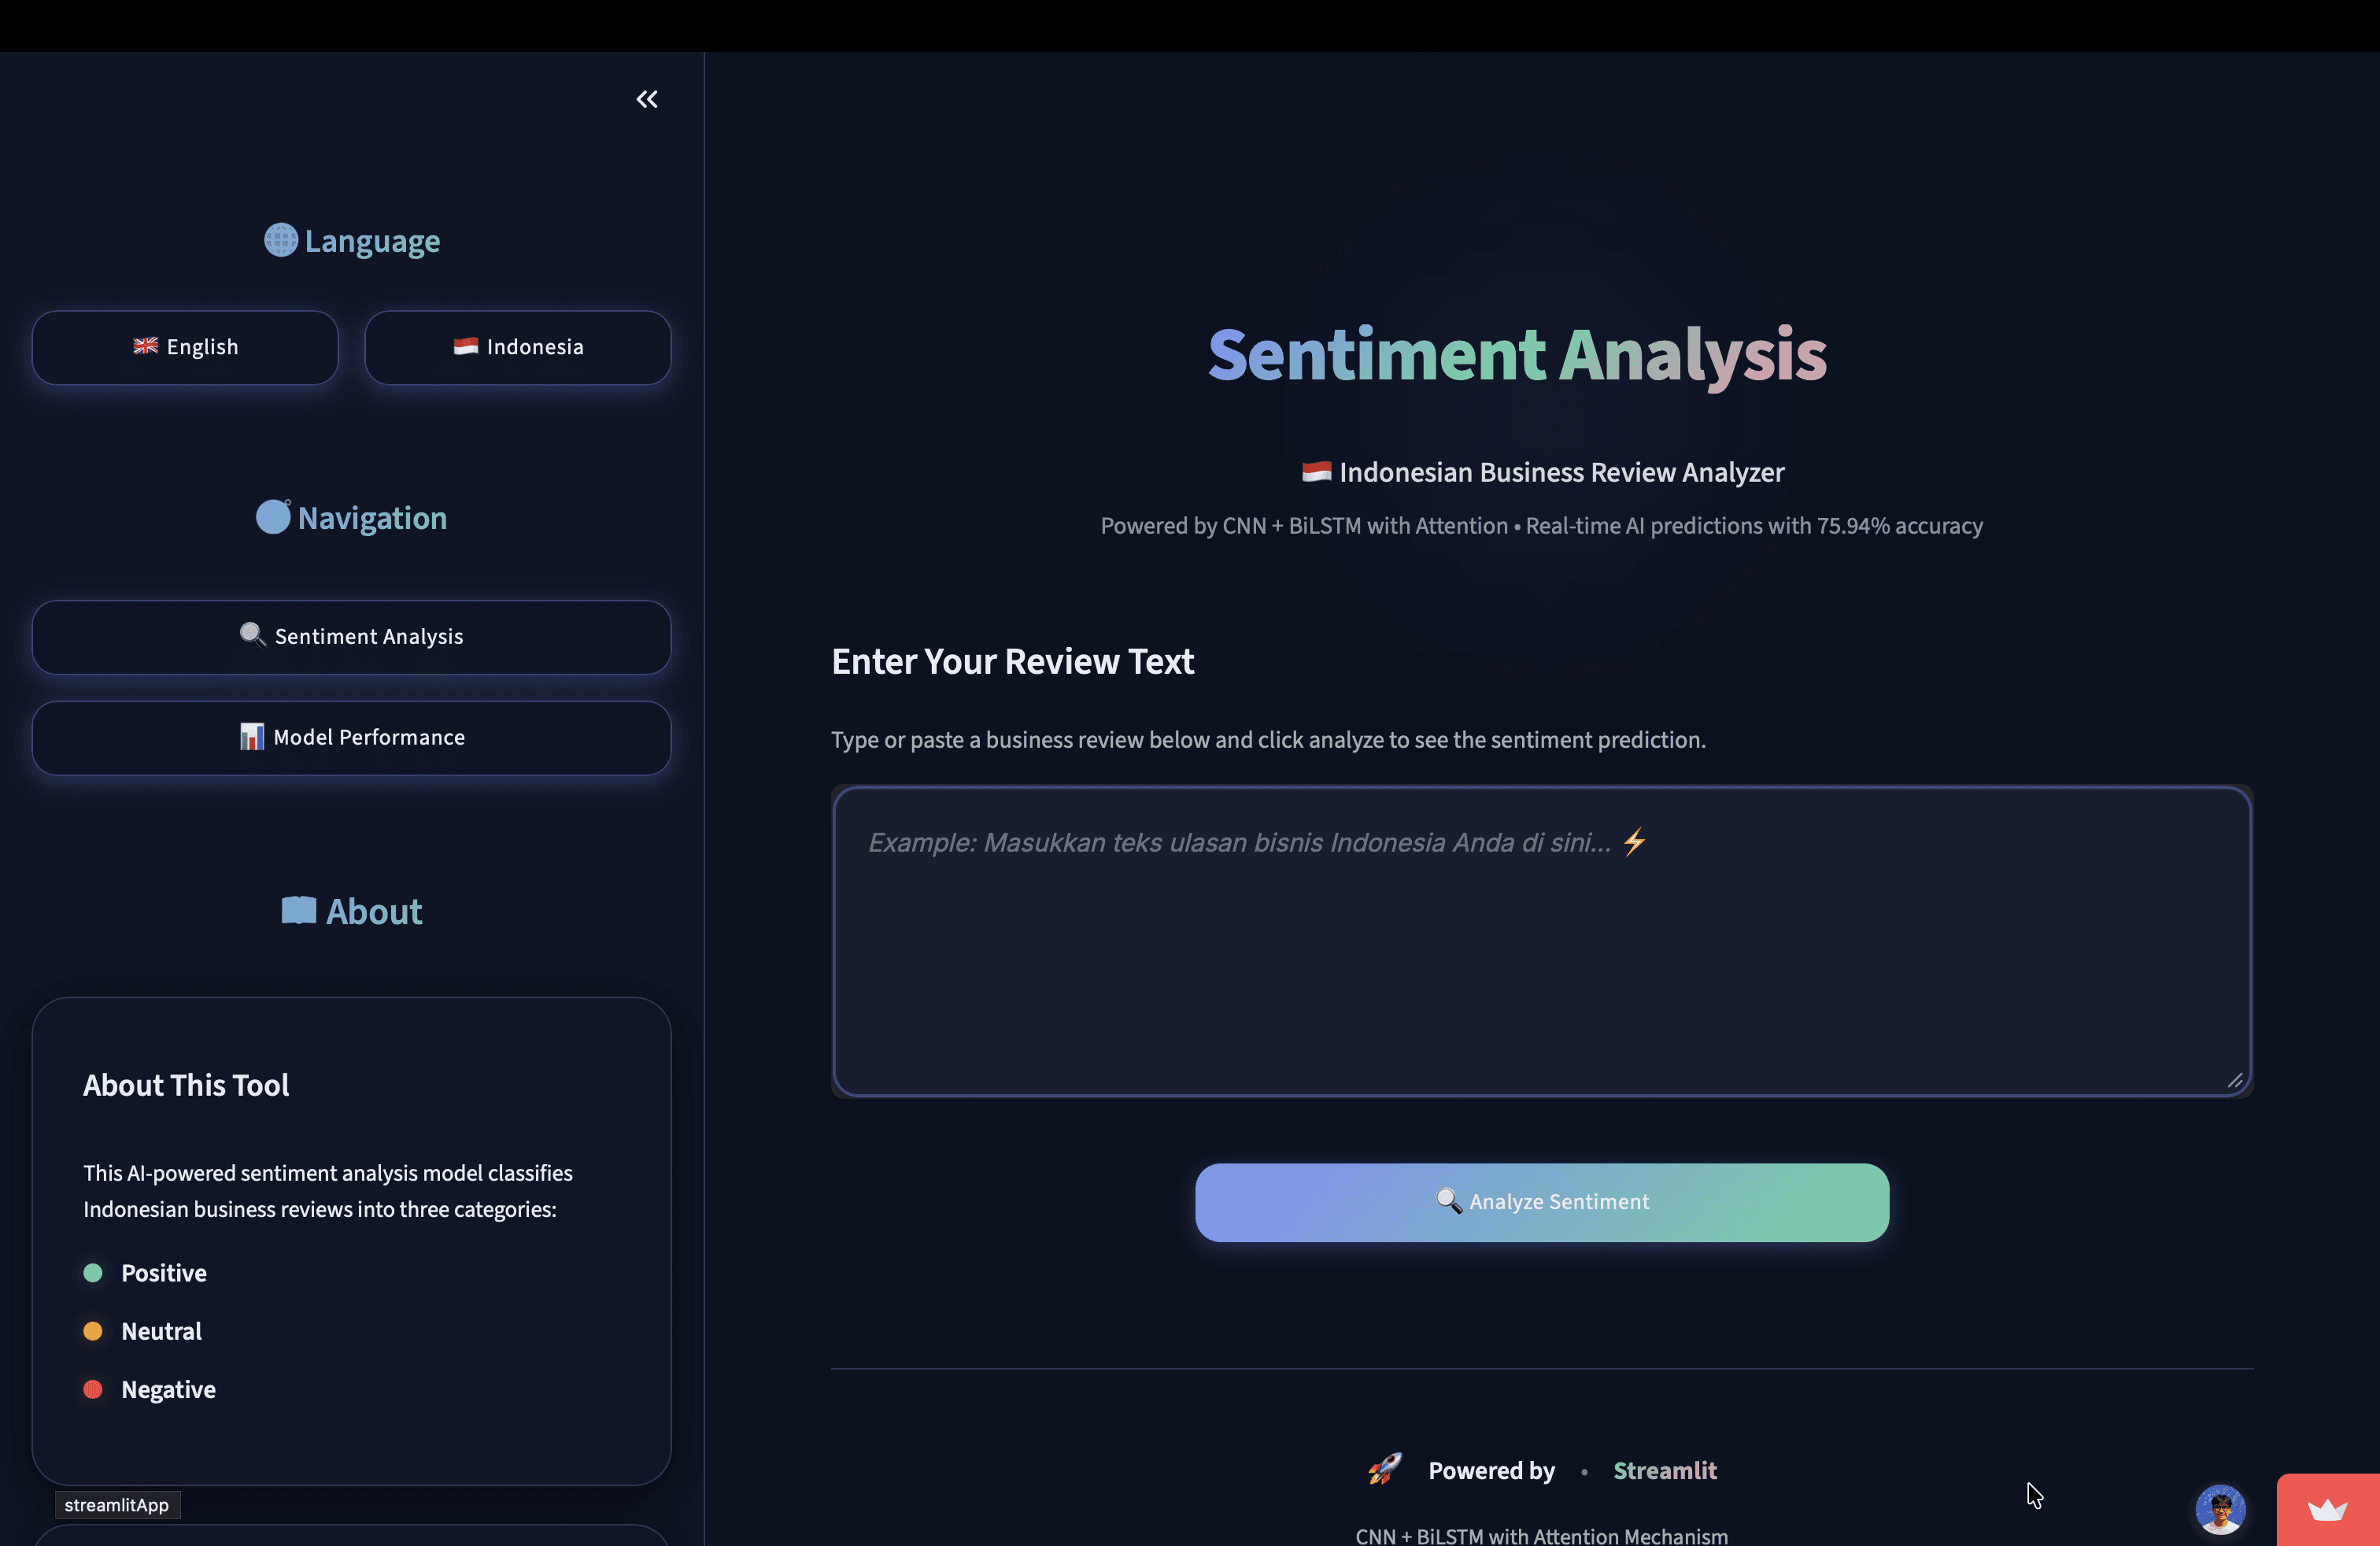
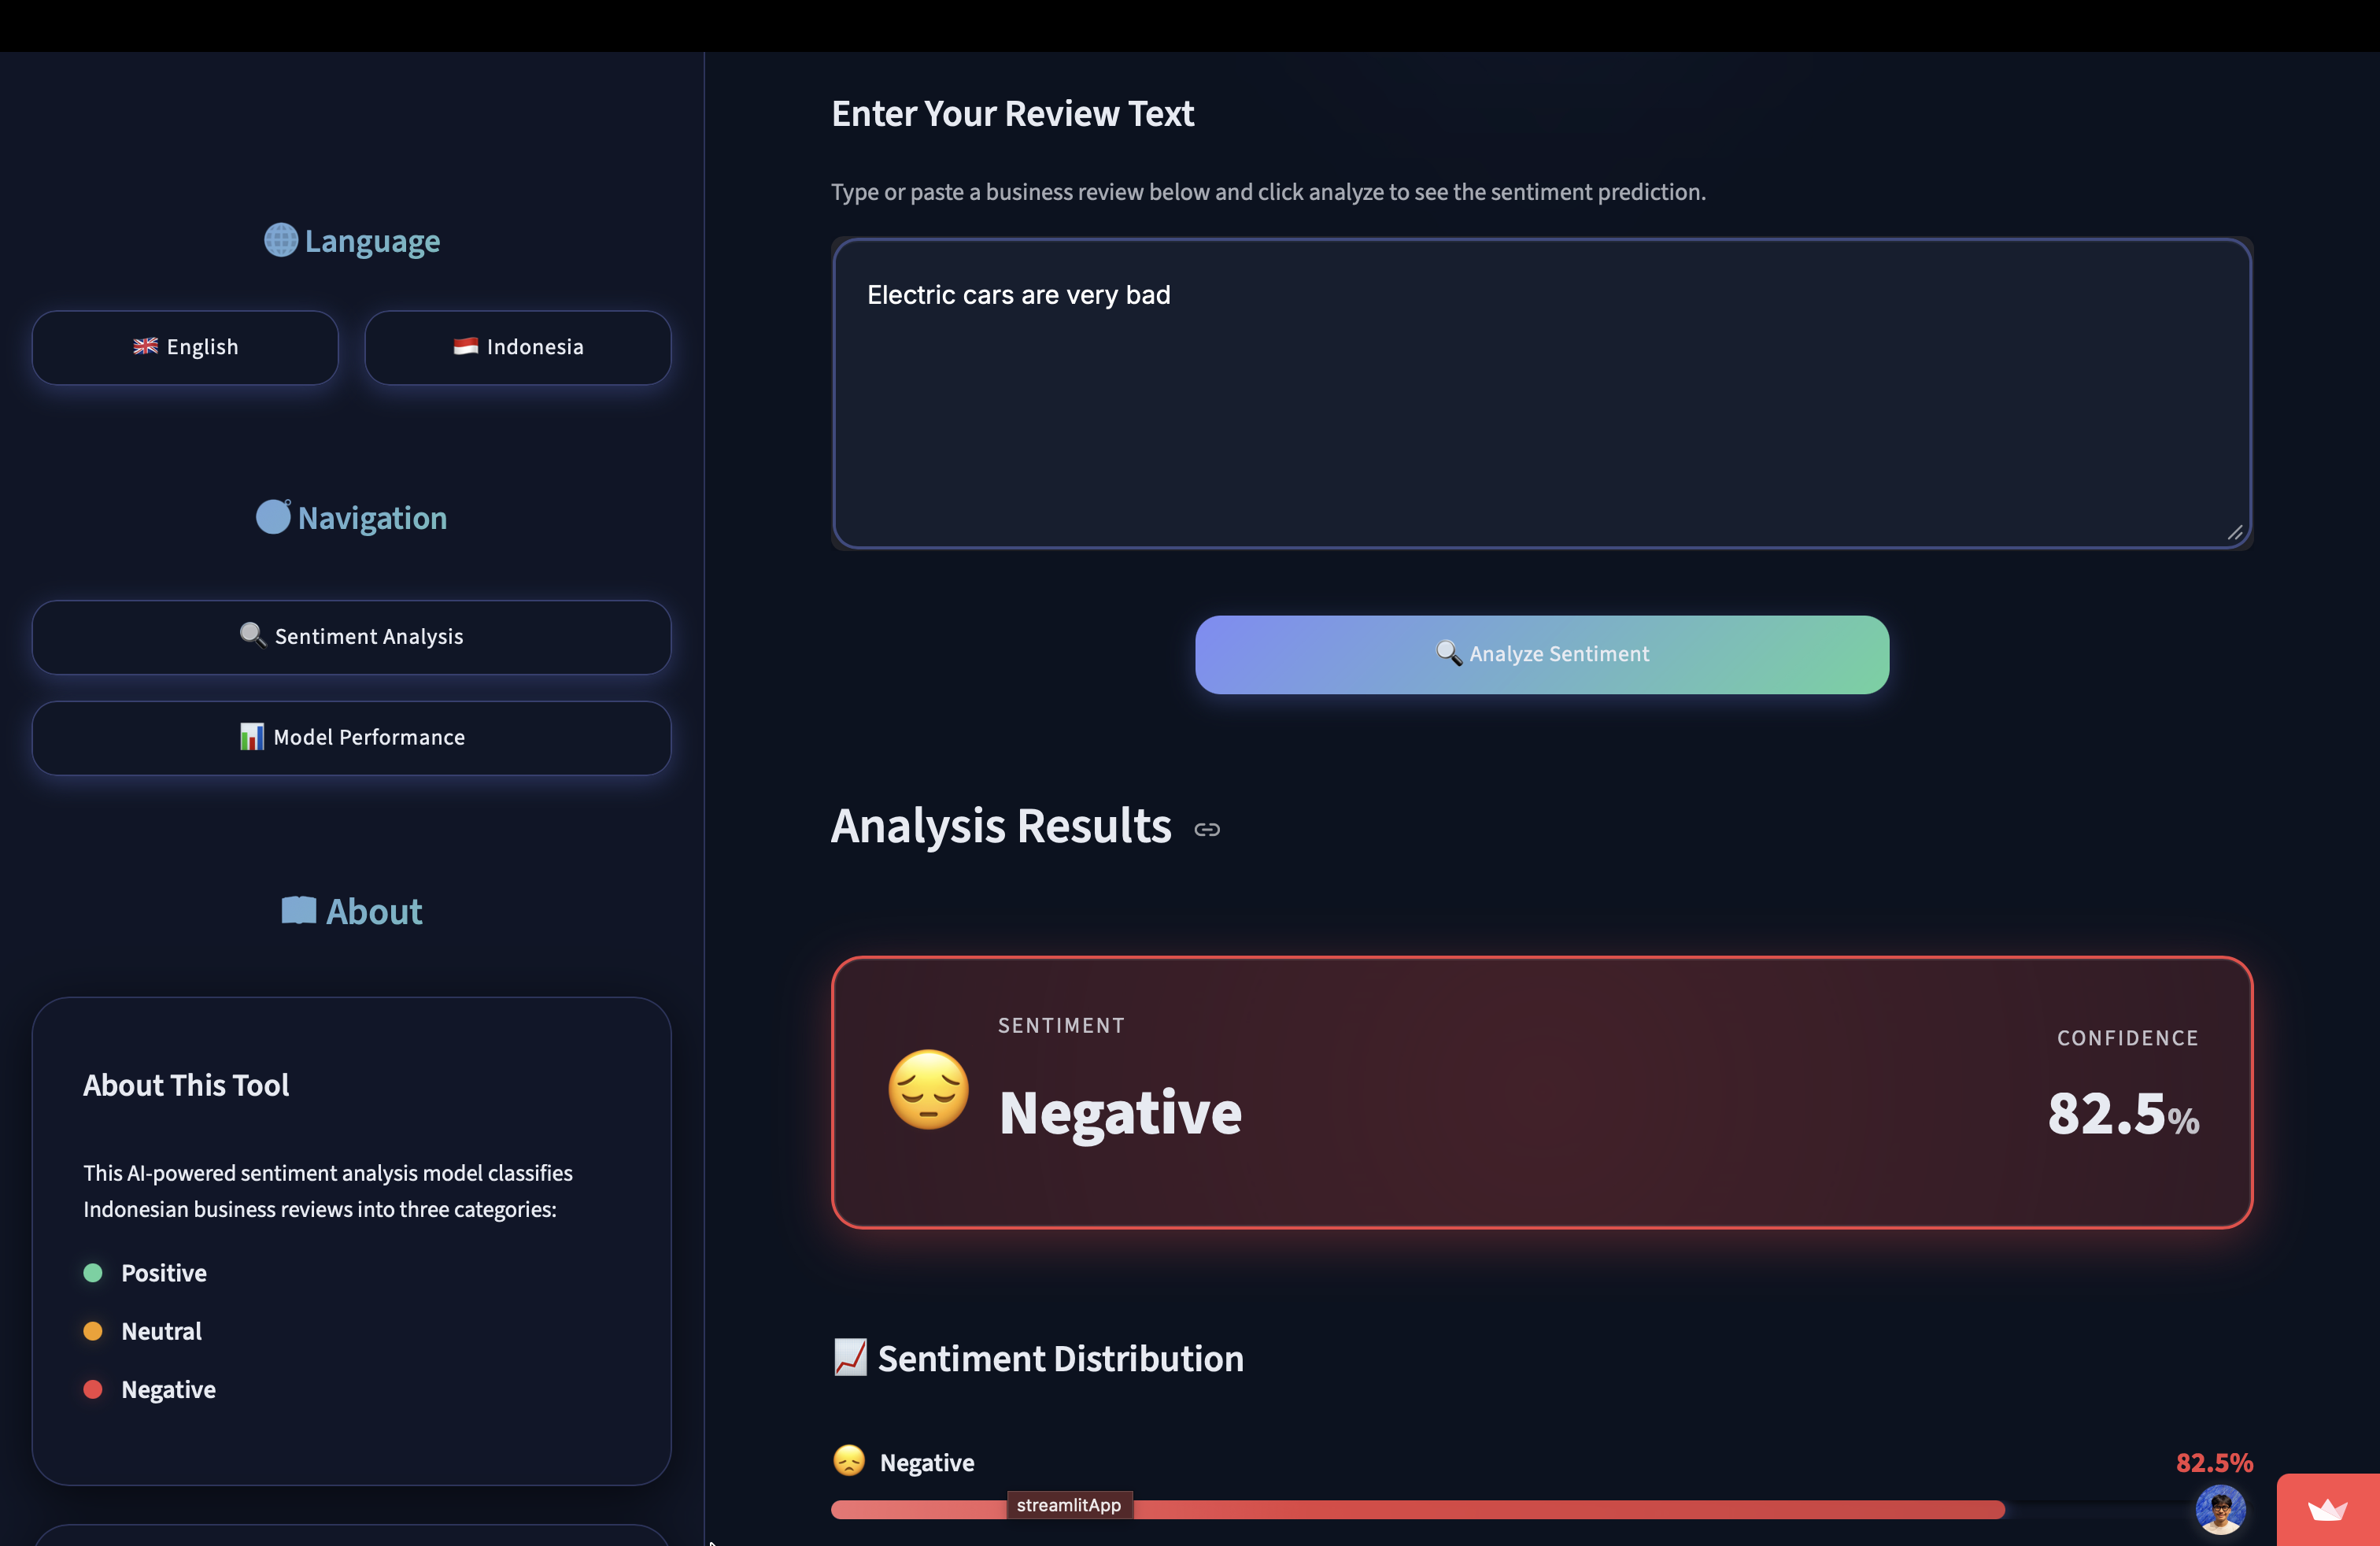
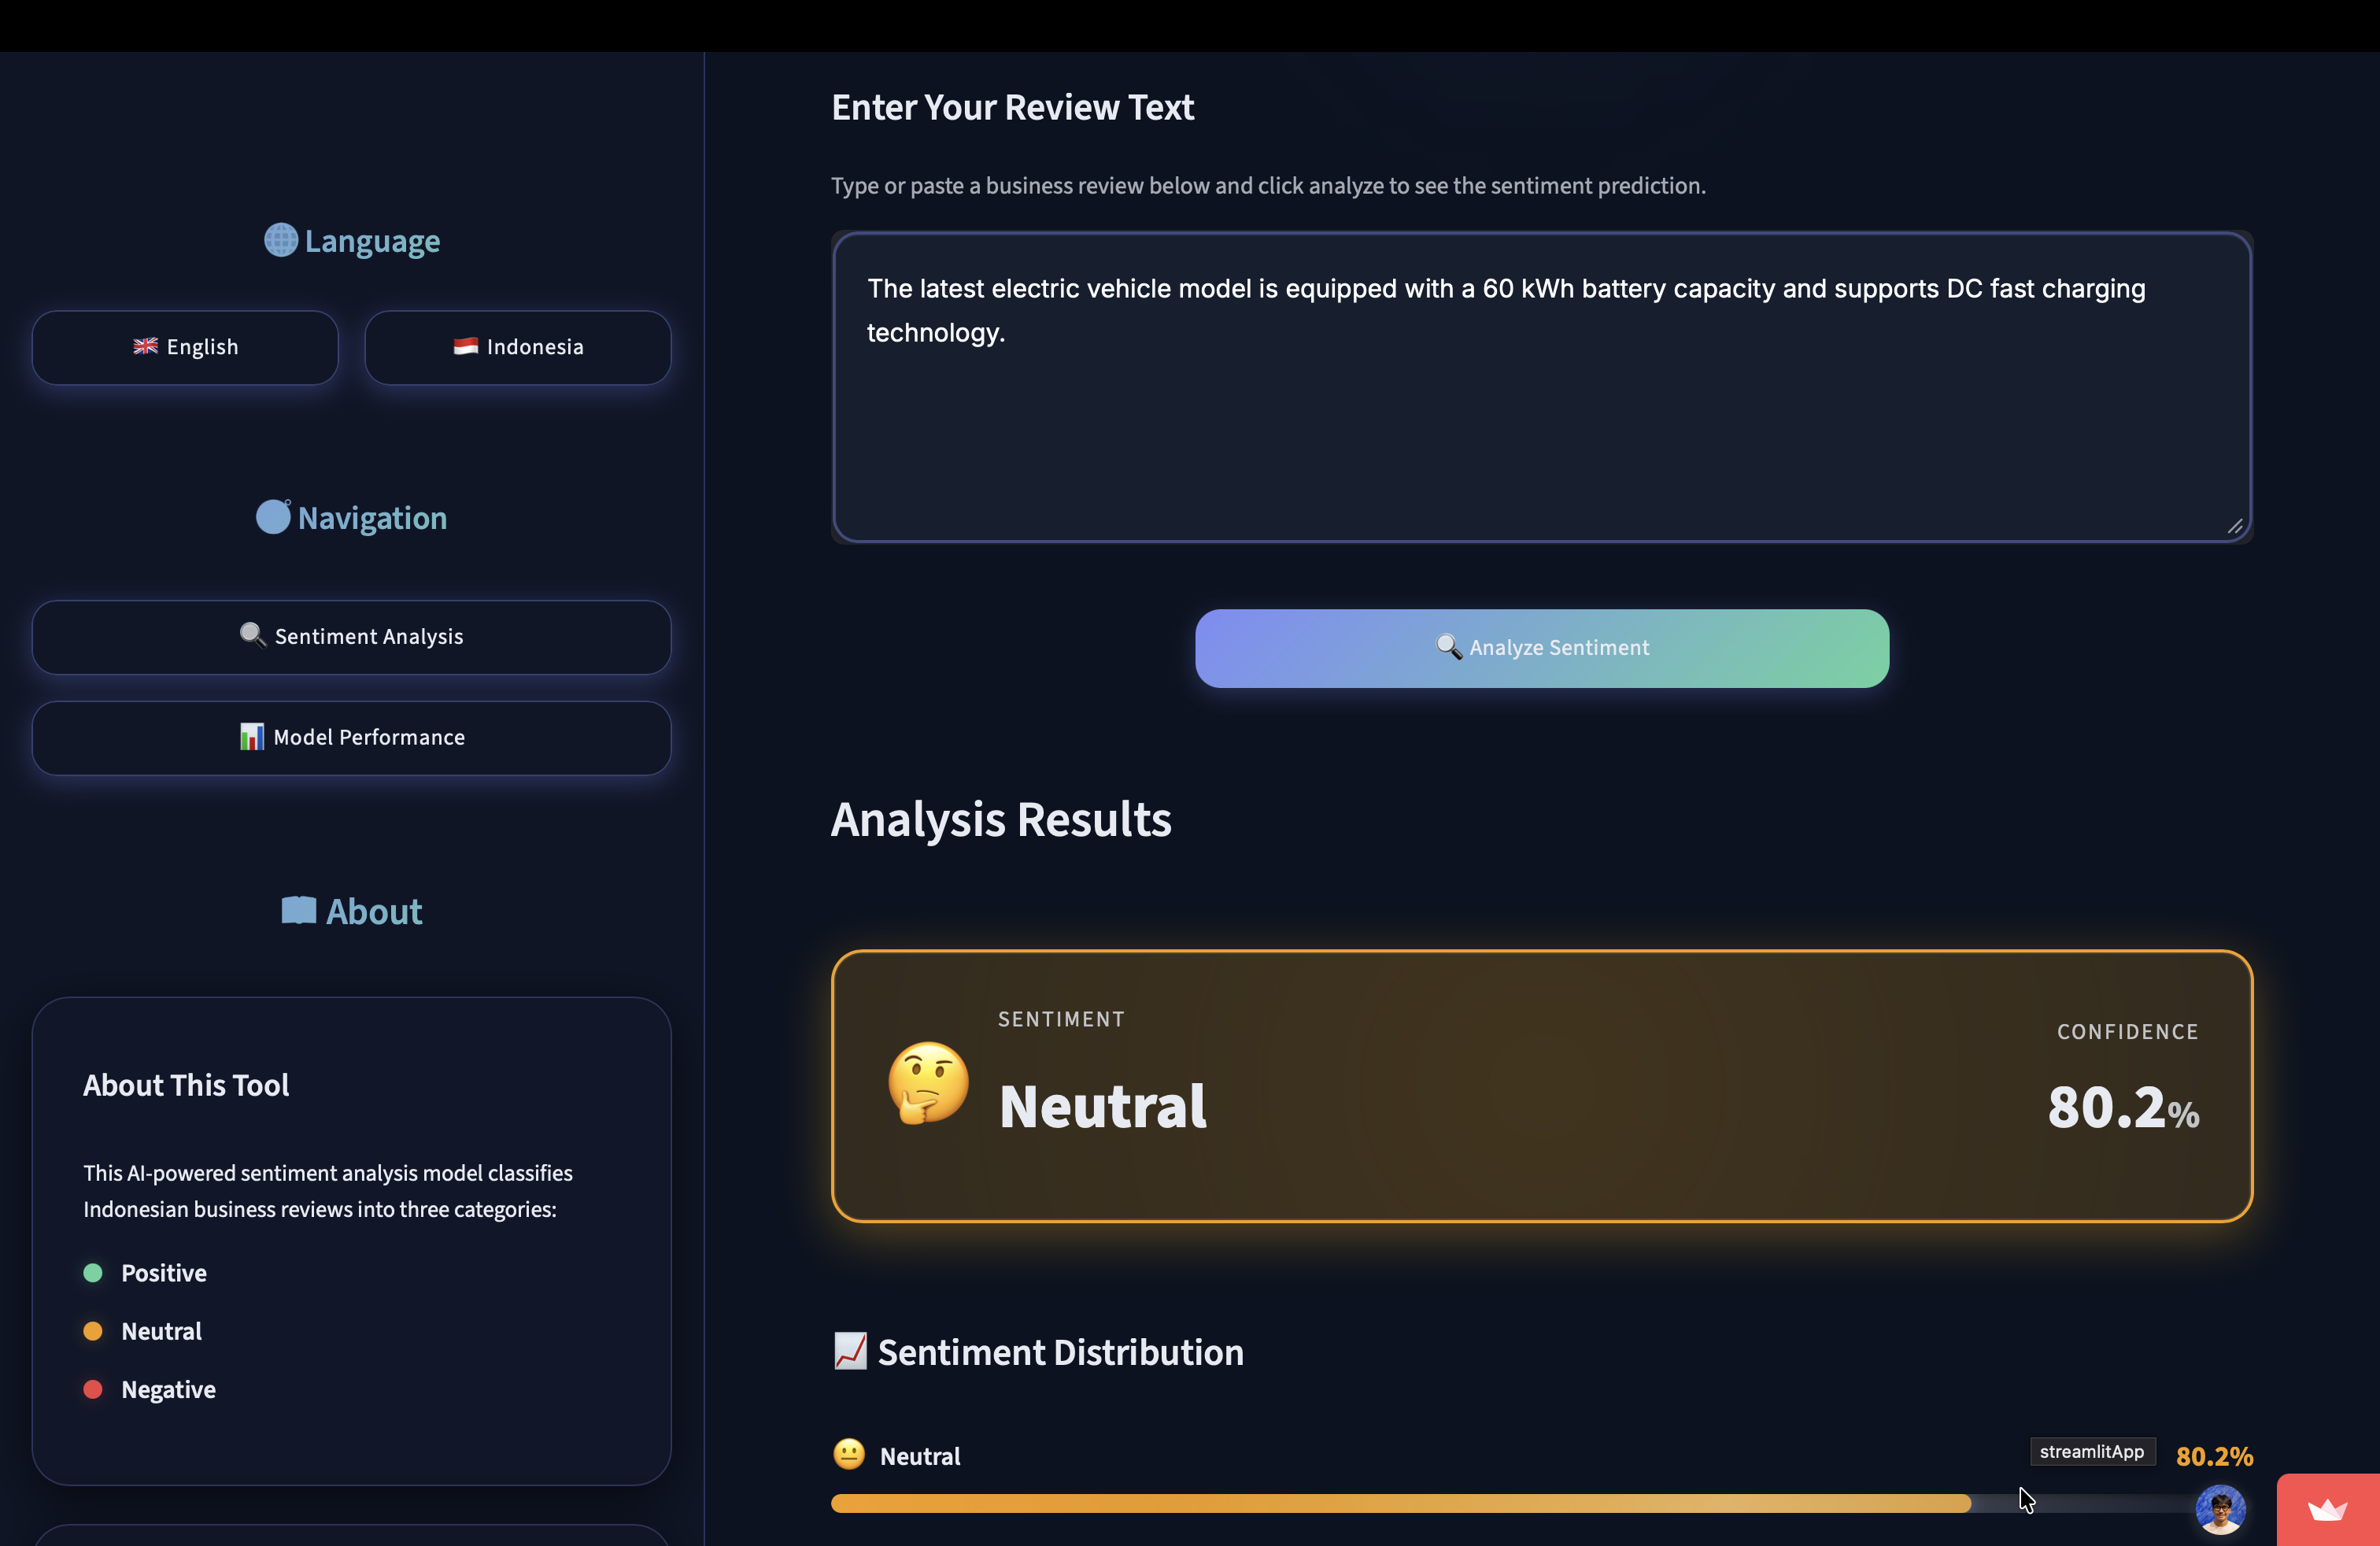
Tugas akhir saya: membandingkan model CNN, LSTM, BiLSTM, dan hybrid CNN+BiLSTM-Attention untuk mengklasifikasikan sentimen berbahasa Indonesia terhadap kendaraan listrik dari Platform X, diimplementasikan sebagai demo web Streamlit.

Timeline: September – Desember 2025
Ini adalah skripsi (Tugas Akhir) saya di Universitas 17 Agustus 1945 Surabaya, proyek akhir yang wajib ditempuh untuk lulus dengan gelar Sarjana Komputer di bidang Informatika. Skripsi ini membandingkan empat arsitektur deep learning untuk mengklasifikasikan sentimen berbahasa Indonesia terhadap kendaraan listrik, menggunakan diskusi publik asli yang dikumpulkan dari Platform X (dulu Twitter).
Judul: Analisis Sentimen Terhadap Ulasan Online untuk Kendaraan Listrik Menggunakan Deep Learning di Platform X.
Kenapa topik ini: perhatian publik terhadap kendaraan listrik di Indonesia sudah berkembang cukup besar hingga menghasilkan diskusi yang terus-menerus, berantakan, dan penuh opini di media sosial. Itulah jenis data tidak terstruktur dan subjektif yang memang menjadi alasan analisis sentimen dibutuhkan, dan perbandingan model yang sistematis atas data ini berguna bagi tiga audiens berbeda: peneliti yang mengembangkan riset analisis sentimen dan NLP, industri otomotif yang ingin tahu apa yang sebenarnya dipikirkan masyarakat tentang kendaraan mereka, dan calon pembeli yang ingin mengukur opini publik sebelum membeli.
Empat arsitektur dilatih dan dibandingkan langsung pada data dan tugas yang sama: mengklasifikasikan tweet sebagai Positif, Negatif, atau Netral.
Dataset berupa tweet berbahasa Indonesia tentang kendaraan listrik, dikumpulkan sejak 1 Januari 2023 hingga 30 Agustus 2025 lewat crawler khusus, dengan 26.852 sampel tersisa setelah praproses.
Pelabelan tidak memakai ambang leksikon tetap, yang merupakan pendekatan default dan lebih sederhana. Sebaliknya, setiap tweet mendapat skor sentimen berbasis leksikon (InSet ditambah leksikon pelengkap), dan batas labelnya ditentukan secara dinamis per dataset menggunakan kuantil: di bawah Q1 dianggap Negatif, di atas Q3 dianggap Positif, dan rentang tengahnya Netral. Intinya adalah ambang yang menyesuaikan diri dengan distribusi skor dataset ini secara spesifik, bukan ambang tetap yang mengasumsikan bentuk distribusi yang belum tentu sesuai.
Praproses: pembersihan (URL, mention, hashtag, emoji, karakter non-alfanumerik), normalisasi kata gaul terhadap kamus slang khusus, case folding, dan stemming lewat Sastrawi. Teks diubah menjadi sequence berpanjang tetap (128 token, dengan padding) lewat trainable embedding layer Keras, tanpa word vector pretrained.
Setiap dari empat arsitektur dilatih dengan tiga anggaran epoch (50, 100, 150) menggunakan optimizer Adam, loss categorical cross-entropy, class weight untuk mengatasi ketidakseimbangan label, serta EarlyStopping dan checkpointing model untuk mencegah overfitting dan menyimpan bobot dengan performa terbaik.
| Model | Akurasi | Macro F1 | Weighted ROC-AUC |
|---|---|---|---|
| CNN + BiLSTM (hybrid) | 75% | 0,76 | ~0,90 |
| BiLSTM | 73% | 0,73 | ~0,88 |
| CNN | 72% | 0,72 | ~0,88 |
| LSTM | 43% | 0,20 | 0,50 |
Model hybrid unggul di semua metrik. LSTM satu arah praktis gagal total: hasilnya runtuh menjadi hanya memprediksi kelas mayoritas dan tidak pernah pulih, performanya tidak lebih baik dari lempar koin (AUC 0,50), berapa pun lama pelatihannya.
Yang terungkap dari variasi epoch (Tabel 4.6) justru lebih menarik daripada angka utamanya. Skor F1 CNN malah menurun seiring pelatihan bertambah dari 50 ke 150 epoch (0,744 menjadi 0,721), kurva overfitting yang klasik. BiLSTM tetap stabil di ketiganya (plateau yang stabil). Model hybrid adalah satu-satunya yang terus membaik dengan pelatihan lebih lama (0,751 menjadi 0,760), artinya model ini punya kapasitas belajar yang tidak dimiliki arsitektur lain, dan karena itu dipilih pada 150 epoch untuk deployment.
Di mana model ini masih kesulitan: bahkan model hybrid yang menang pun sumber kesalahan terbesarnya adalah keliru membedakan Positif dengan Netral. Recall-nya untuk kelas Positif saja hanya 0,63. Membedakan positivitas ringan dari komentar netral ternyata jadi bagian tersulit dari tugas ini, bukan memisahkan sentimen yang jelas positif dari yang jelas negatif.

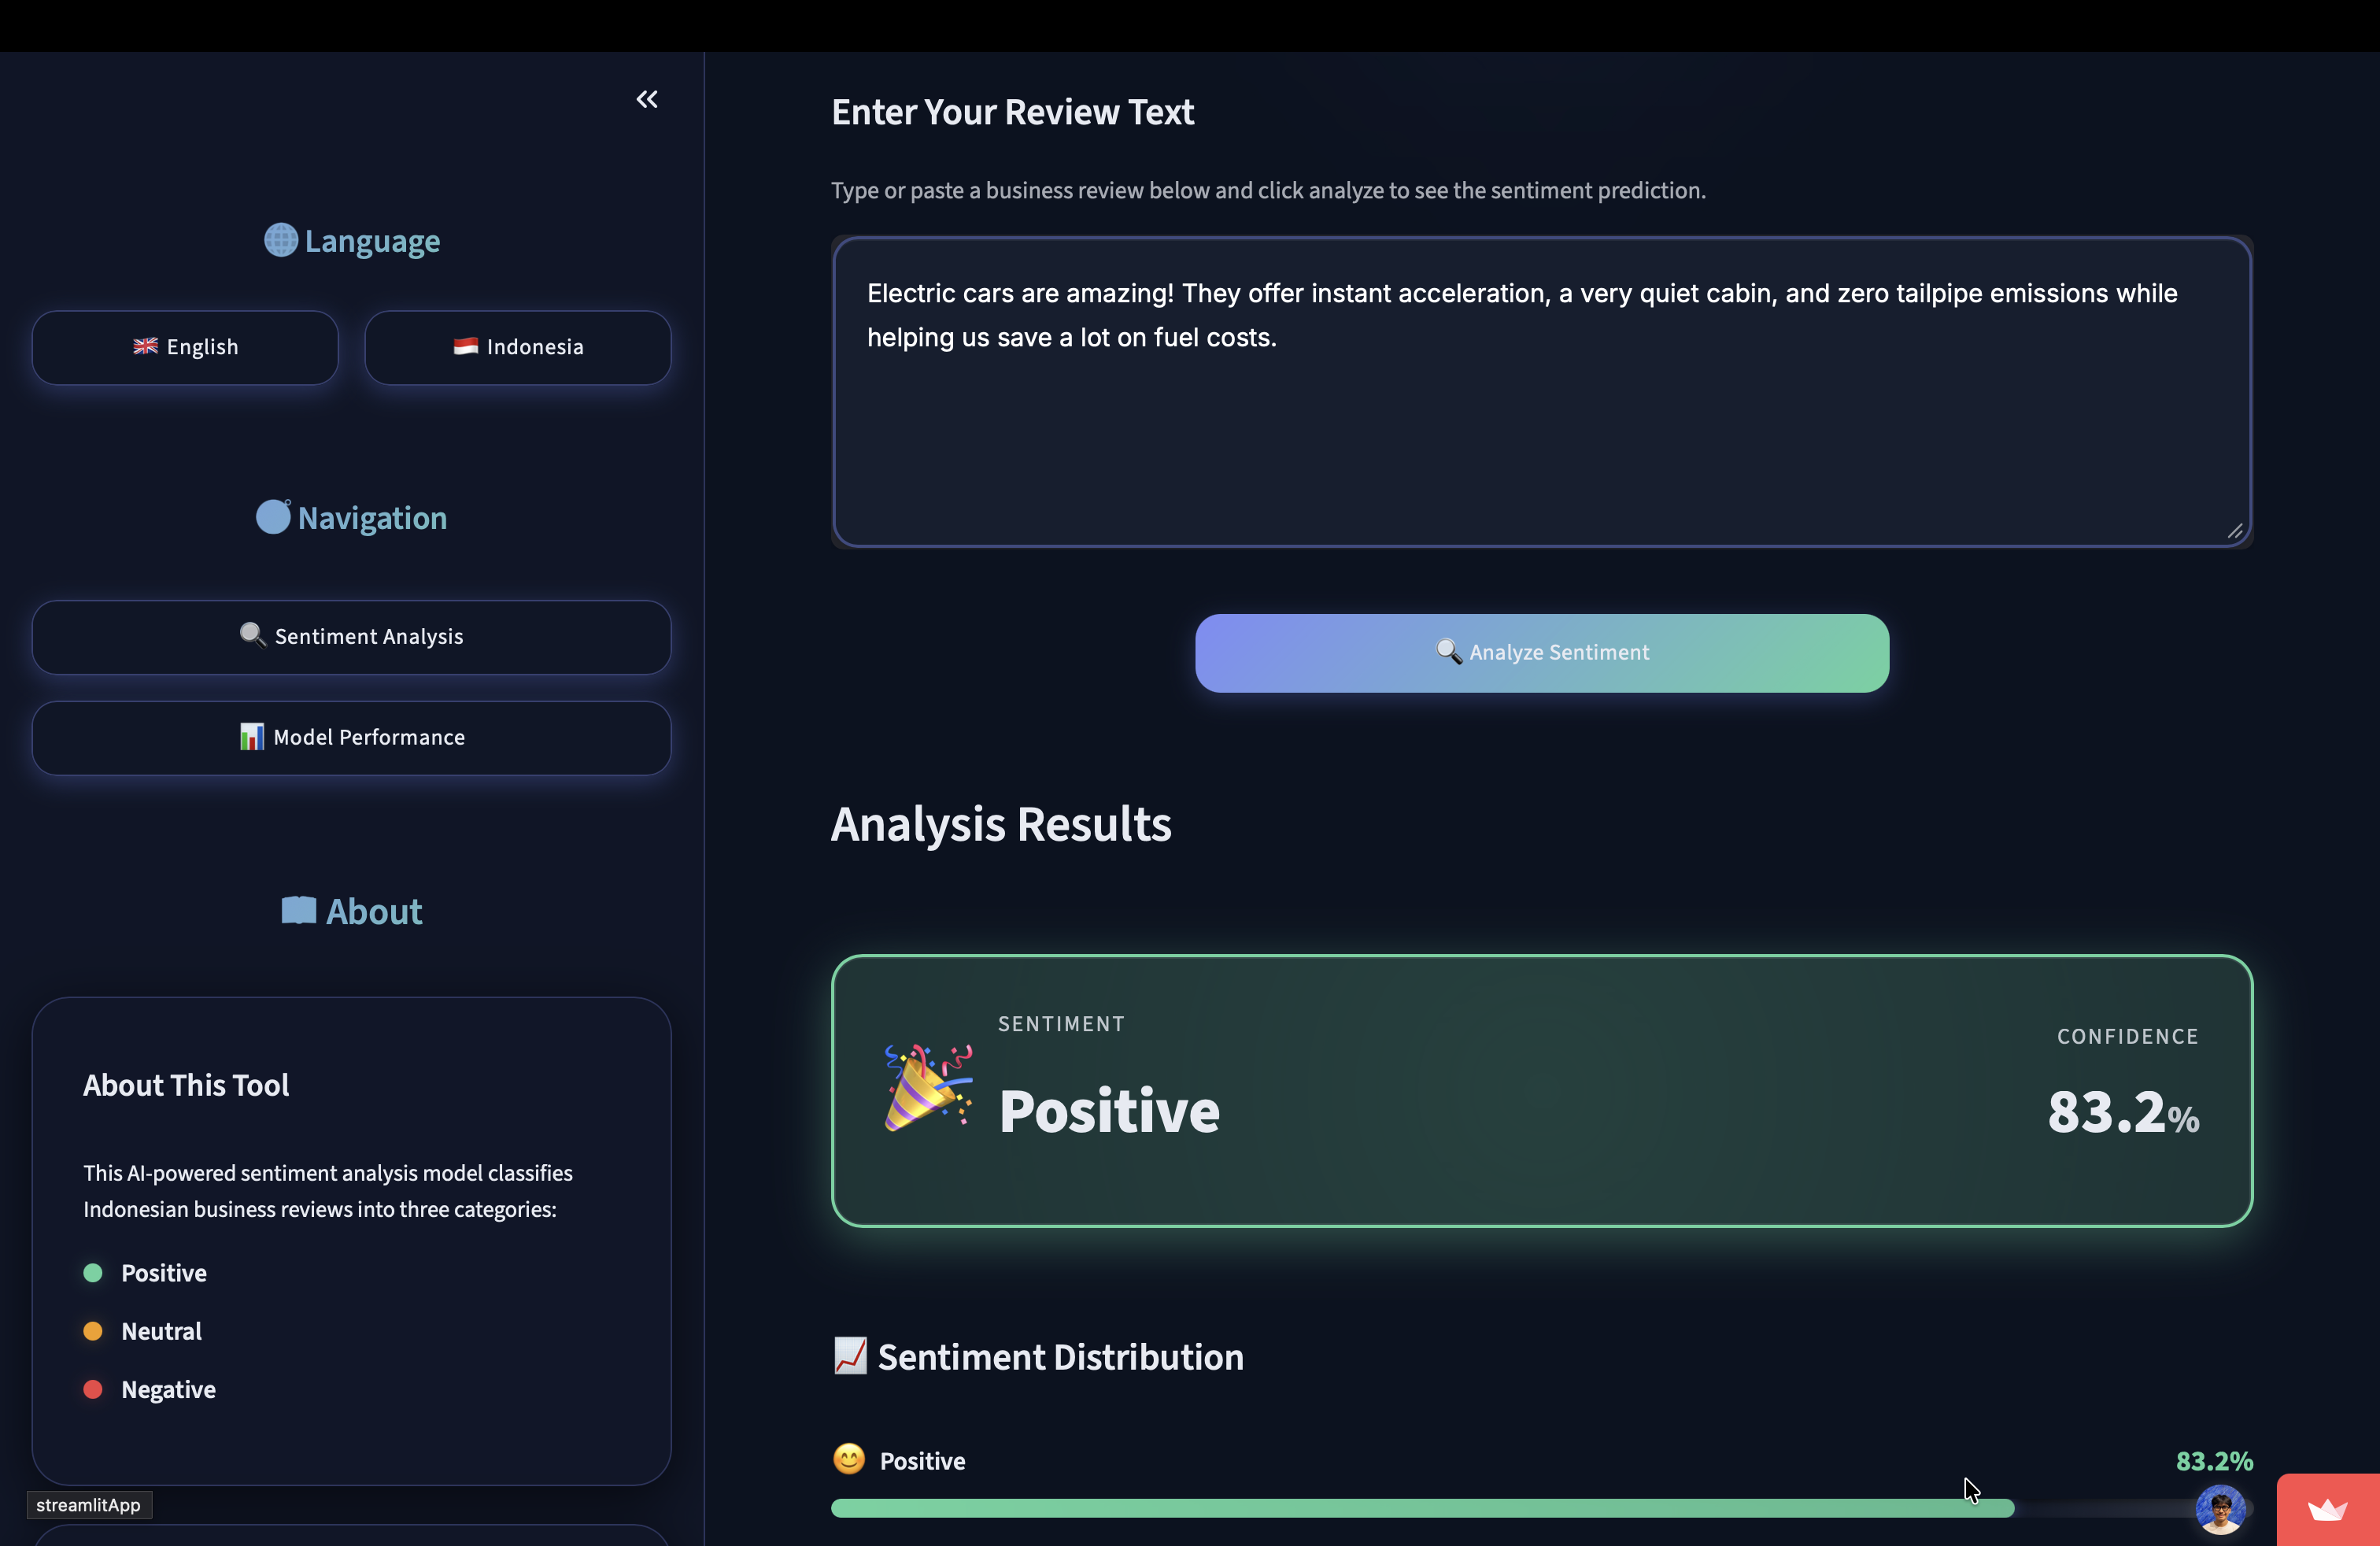
Model, tokenizer, dan label encoder dengan performa terbaik diekspor dan dihubungkan ke aplikasi web Streamlit. Ketik sebuah ulasan, klik analisis, dan aplikasi menjalankan pipeline praproses yang sama seperti saat pelatihan sebelum mengembalikan prediksi lengkap dengan skor keyakinannya.


Perlu diperjelas: riset dan evaluasi, yaitu semua angka di atas, berasal dari model CNN+BiLSTM-Attention TensorFlow/Keras yang dilatih khusus seperti dijelaskan di skripsi. Aplikasi demo publiknya, karena alasan praktis deployment, memanggil model sentimen HuggingFace pretrained (PyTorch), bukan langsung memuat model Keras kustomnya. UI dan pipeline yang ditampilkan sama persis dengan yang dibangun untuk skripsi; backend inferensi di balik tautan publiknya diganti dengan versi yang lebih ringan agar deployment tingkat gratis tetap cepat dan andal.
| Lapisan | Pilihan |
|---|---|
| Bahasa | Python |
| Deep learning | TensorFlow / Keras (riset & pelatihan) |
| Inferensi deployment | PyTorch, HuggingFace Transformers |
| Data & metrik | pandas, NumPy, scikit-learn |
| NLP Bahasa Indonesia | Sastrawi (stemming), leksikon InSet |
| Notebook | Jupyter |
| Aplikasi web | Streamlit |